A rastreabilidade no lado do servidor não se trata de precisão, mas de criar um buffer
 Escrito porRonny Rangel
Muitos clientes, especialmente aqueles novos na rastreabilidade no lado do servidor, percebem isso apenas após investir na tecnologia. Eles ficam surpresos ao
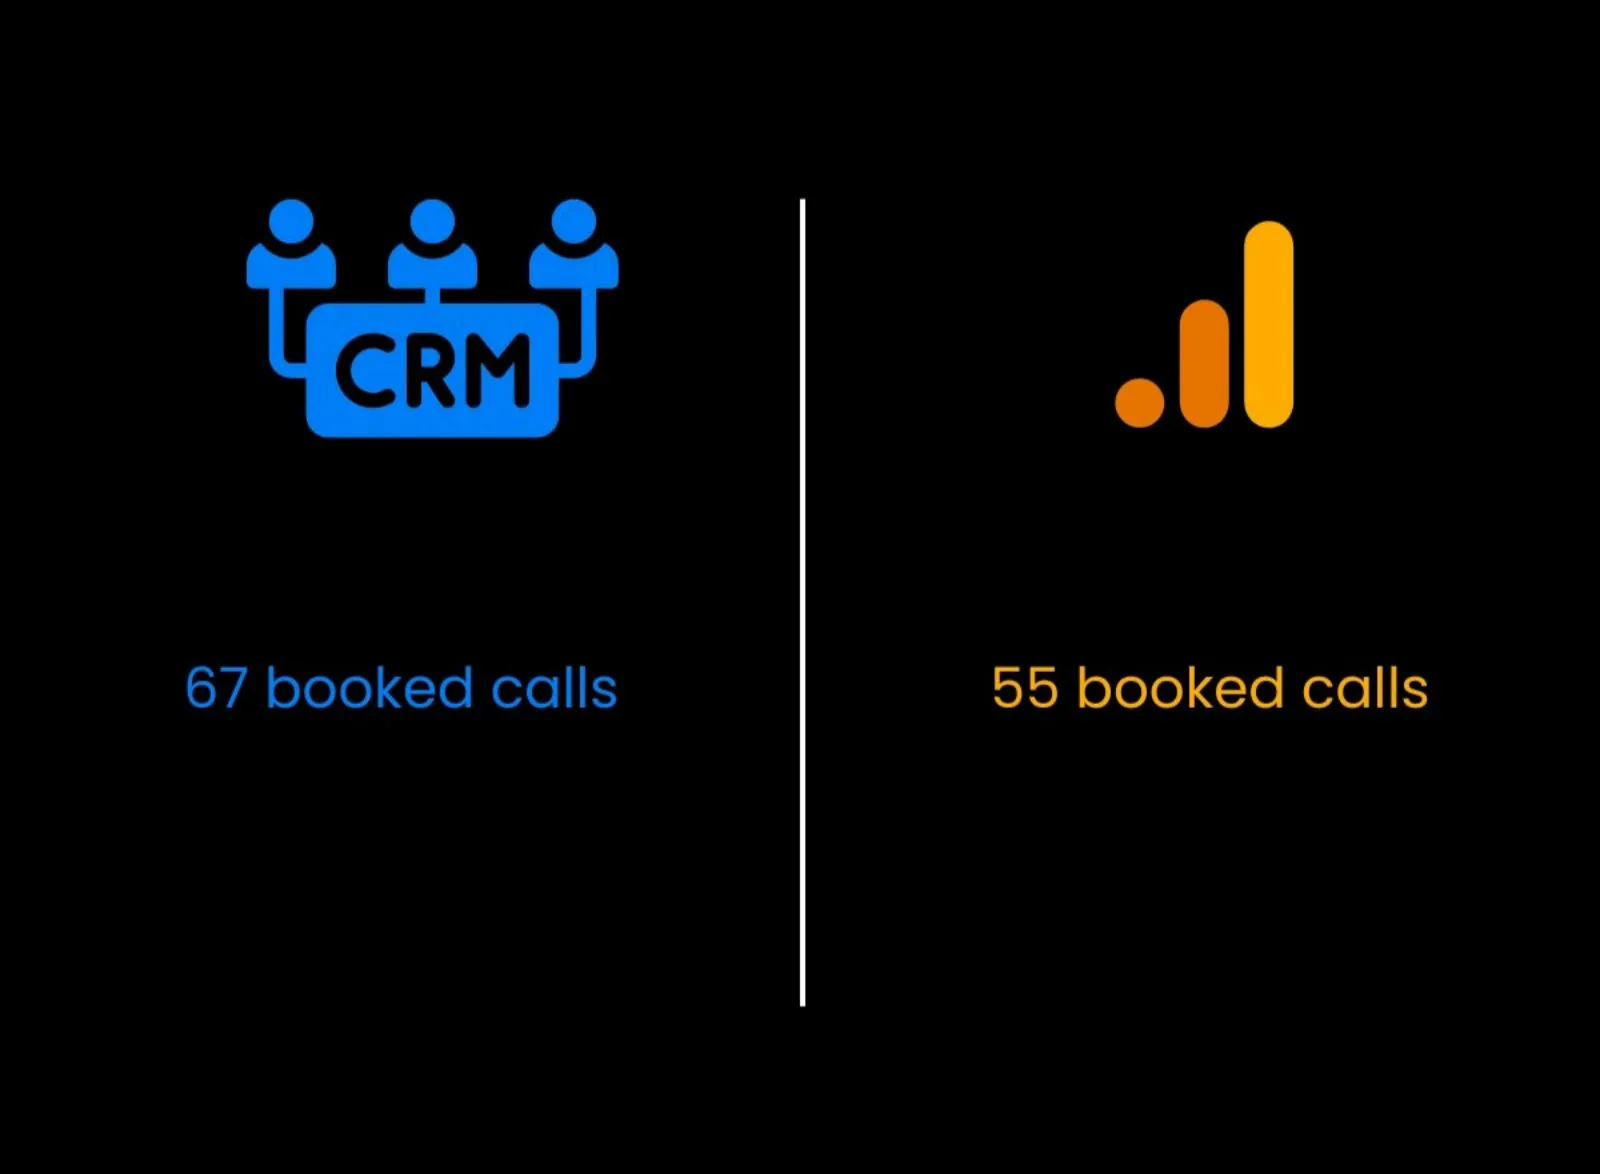
Muitos clientes, especialmente aqueles novos na rastreabilidade no lado do servidor, percebem isso apenas após investir na tecnologia. Eles ficam surpresos ao descobrir que o gap entre sua fonte de verdade (CRM, backoffice…) e a análise ainda existe.
Frequentemente, os fornecedores exageram na venda da rastreabilidade no lado do servidor como uma solução rápida. Isso leva a expectativas falsas sérias.
Às vezes, a ‘sugestão’ deles é apenas um esforço disfarçado para adquirir dados do usuário por meio da implementação do lado do servidor no seu site.
Então, por que investir nessa tecnologia?
O que você realmente ganha é controle.
Você adiciona um segundo filtro, ou ‘buffer’, entre você e os fornecedores que tentam extrair dados do seu site.
Pense nisso como um aprimoramento na sua configuração.
Sim, você está recuperando alguns dos dados perdidos devido a bloqueadores de anúncios/bloqueadores de rastreamento, mas ainda encontrará discrepâncias; essa é a realidade do rastreamento na web.
Isso não é para desanimá-lo. Longe disso. Trata-se de definir as expectativas corretas.
Também siga o Mundo do Traqueamento em outras redes sociais:
Inscreva-se no: https://www.youtube.com/channel/UC6mX6bbcEmQoaznI0D7Aw5Q
Siga e curta no: https://www.instagram.com/mundodotraqueamento/
Siga e comente no: https://twitter.com/traqueamento
Quer colocar isso em prática?
Falar com a equipeEste artigo foi útil?
Comentários
Ainda não tem comentário. Comece a conversa.